
Perplexity 搜尋不到你的公司,先查它的搜尋爬蟲 PerplexityBot 能否進入網站:robots.txt 有否封鎖它,防火牆有否擋下它的官方 IP。另一支 Perplexity-User 只在用戶提問時讀取網頁,不負責搜尋收錄。
按 Perplexity 官方文件,它的搜尋結果會連結網站,回應亦可能附上所讀網頁的連結,方便自己核對來源。下面先講清兩支爬蟲的分工,再給四個無須安裝軟件的自查步驟。ChatGPT 的情況另見《怎樣讓 ChatGPT 推薦你的網站?搜尋得到之後要做的五件事》。
Perplexity 的兩支爬蟲有甚麼分別?
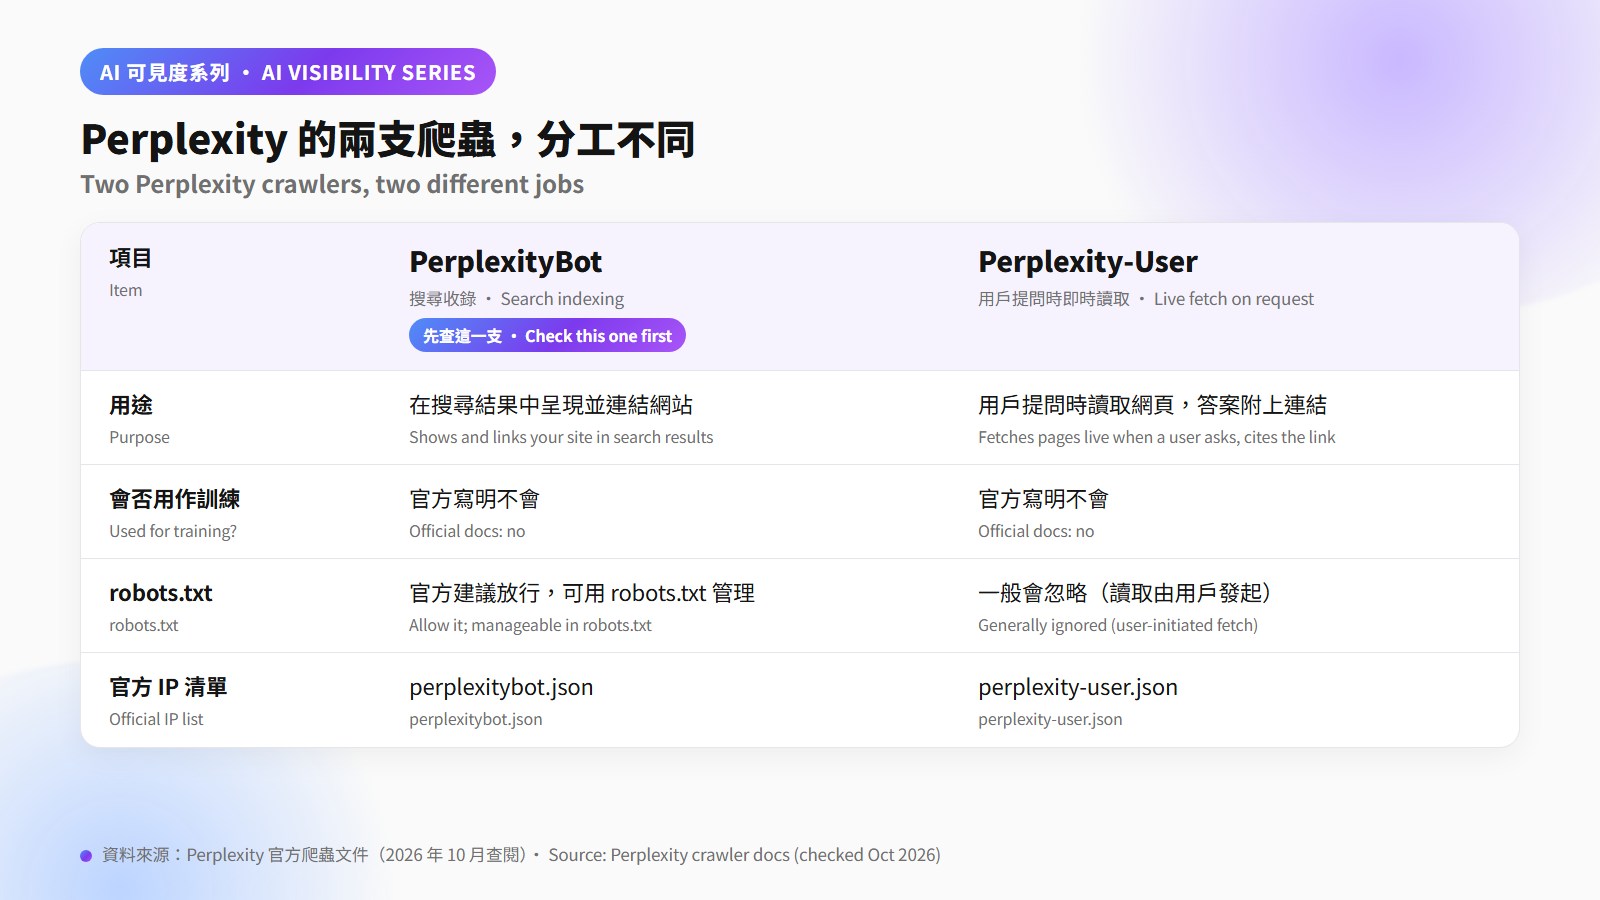
PerplexityBot 管搜尋收錄,Perplexity-User 在用戶提問時即時讀取網頁。Perplexity 官方爬蟲文件(2026 年 10 月查閱)寫明,PerplexityBot 的用途是在 Perplexity 的搜尋結果中呈現並連結網站,不用於為 AI 基礎模型抓取內容;想網站出現在搜尋結果,官方建議在 robots.txt 放行它,並放行官方公布的 IP 範圍。
同一份文件說明,用戶向 Perplexity 提問時,Perplexity-User 可能造訪網頁以提供準確答案,並在回應中附上該頁連結;它不用於爬取網頁,亦不用於收集訓練內容。由於讀取是由用戶發起,文件寫明這支爬蟲一般會忽略 robots.txt 規則。
| 爬蟲 | 用途 | 會否用作訓練 | robots.txt | 官方 IP 清單 |
|---|---|---|---|---|
| PerplexityBot | 在搜尋結果中呈現並連結網站 | 官方寫明不會 | 官方建議放行 | perplexitybot.json |
| Perplexity-User | 用戶提問時讀取網頁,答案附上連結 | 官方寫明不會 | 一般會忽略 | perplexity-user.json |
所以「Perplexity 搜尋不到」要先看 PerplexityBot。OpenAI 的爬蟲文件分法相近:OAI-SearchBot 管搜尋,ChatGPT-User 處理用戶操作。
第一步:robots.txt 有否封鎖 PerplexityBot?
在瀏覽器打開「你的域名/robots.txt」,搜尋 PerplexityBot。看到它底下有 Disallow: /,或者 User-agent: * 底下有 Disallow: / 而沒有另外為 PerplexityBot 開放,即屬封鎖。另外要確認 robots.txt 打開後直接顯示純文字規則,而不是轉去另一個網頁或顯示錯誤頁;Perplexity 文件沒有說明它怎樣處理這類情況,最穩妥是讓規則檔案可以直接讀取。放行的寫法:
User-agent: PerplexityBot
Allow: /
Perplexity 官方文件寫明,每個設定獨立運作,系統最多需要 24 小時反映改動,改完翌日再測試。其他 AI 爬蟲的名單與寫法見《AI 爬蟲完整指南》。
第二步:防火牆有否擋下 Perplexity 的官方 IP?
robots.txt 放行了,請求仍可能在防火牆被擋,所以要按官方 IP 清單放行。Perplexity 官方文件提供兩份清單:PerplexityBot 用 perplexitybot.json,Perplexity-User 用 perplexity-user.json,並建議規則同時比對 User-Agent 與 IP,每支爬蟲對應自己的 IP 範圍。User-Agent 只是一串自報的名稱,官方的最佳做法是兩者一併核對,以提高保安,同時確保真正的 Perplexity 爬蟲進得來。
文件列出兩個常見防火牆的設定:
- Cloudflare:在 Security rules 新增自訂規則,條件寫「User-Agent 含 PerplexityBot 而且來源 IP 在官方清單內」,動作選 Skip,並勾選要略過的保安功能(官方例子有 All remaining custom rules、All managed rules、All rate limiting rules),再把規則放在所有阻擋或質詢規則之上,因為 Skip 只會略過排在它之後的規則。官方特別提醒,Bot Fight Mode 不能用自訂規則略過,開了它仍可能攔截 Perplexity 的爬蟲。
- AWS WAF:為兩支爬蟲各建一個 IP 集,規則同時比對 IP 集與 User-Agent,動作設為 Allow,優先次序排在阻擋規則之前。
同一份文件說明 IP 清單會定期更新,建議設定自動程序定期取得最新範圍。網站由建站公司或寄存商代管的話,把兩個 JSON 網址交給他們處理即可。改好後,可以在伺服器存取日誌搜尋 PerplexityBot,並核對來源 IP 是否在官方清單內。
第三步:在 Perplexity 問自家品牌,答案引用了哪些網頁?
直接在 Perplexity 提問,看答案附上的連結有否你的網站。官方文件寫明 PerplexityBot 用於在搜尋結果中連結網站,Perplexity-User 可能在回應中附上所讀網頁的連結;答案附有連結時,可以逐一開啟核對。
建議問三類問題:
- 品牌問題:「某某公司是做甚麼的?」
- 服務加地區:「荃灣有哪些做室內設計的公司?」
- 比較問題:「某某公司與同類服務有甚麼分別?」
每條記下答案有否提到你、連結是否指向你的官網、資料是否正確,並保存截圖與日期,修改網站後用同一組問題重測比較。答案只引用第三方網頁而沒有你的官網,就回到第一、二步再查。
第四步:用 AEO Auditor 看還有甚麼讀不到?
爬蟲進得來之後,還要看網站內容讀不讀得懂。AEO Auditor 輸入網址即可免費檢測,工具頁列明報告涵蓋 AI 爬蟲存取性、schema markup 與內容可回答性,可以一次檢視結構與文案。內容方面的常見原因,例如內容不是可引用的陳述句、品牌資訊不一致,見《為甚麼 ChatGPT 搜尋不到你的公司網站》,亦值得一併檢查。
常見問題
PerplexityBot 會用我的內容訓練模型嗎?
Perplexity 官方文件寫明,PerplexityBot 不用於為 AI 基礎模型抓取內容;Perplexity-User 亦不用於收集訓練內容。
robots.txt 能阻擋 Perplexity-User 嗎?
官方文件寫明,由於讀取由用戶發起,Perplexity-User 一般會忽略 robots.txt 規則。防火牆規則則可以按 User-Agent 與各自的官方 IP 清單分開設定。
改了 robots.txt,Perplexity 多久會更新?
Perplexity 官方文件寫明,系統最多需要 24 小時反映 robots.txt 的改動。
用了 Cloudflare,為甚麼 Perplexity 仍被擋?
其中一個可能是 Bot Fight Mode。官方文件寫明,Bot Fight Mode 不能用自訂規則略過,開了它仍可能攔截 Perplexity 的爬蟲;另外要確認放行規則排在阻擋規則之上,並已勾選要略過的保安功能。
資料來源
- Perplexity,Perplexity Crawlers:https://docs.perplexity.ai/docs/resources/perplexity-crawlers(2026-10-31 查閱)
- Perplexity,PerplexityBot IP 範圍:https://www.perplexity.ai/perplexitybot.json(2026-10-31 查閱)
- Perplexity,Perplexity-User IP 範圍:https://www.perplexity.ai/perplexity-user.json(2026-10-31 查閱)
- OpenAI,Overview of OpenAI Crawlers:https://developers.openai.com/api/docs/bots(2026-10-31 查閱)