
Perplexity 搜索不到你的公司,先查它的搜索爬虫 PerplexityBot 能否进入网站:robots.txt 有否封锁它,防火墙有否挡下它的官方 IP。另一支 Perplexity-User 只在用户提问时读取网页,不负责搜索收录。
按 Perplexity 官方文件,它的搜索结果会链接网站,回应亦可能附上所读网页的链接,方便自己核对来源。下面先讲清两支爬虫的分工,再给四个无须安装软件的自查步骤。ChatGPT 的情况另见《怎样让 ChatGPT 推荐你的网站?搜索得到之后要做的五件事》。
Perplexity 的两支爬虫有什么分别?
PerplexityBot 管搜索收录,Perplexity-User 在用户提问时即时读取网页。Perplexity 官方爬虫文件(2026 年 10 月查阅)写明,PerplexityBot 的用途是在 Perplexity 的搜索结果中呈现并链接网站,不用于为 AI 基础模型抓取内容;想网站出现在搜索结果,官方建议在 robots.txt 放行它,并放行官方公布的 IP 范围。
同一份文件说明,用户向 Perplexity 提问时,Perplexity-User 可能造访网页以提供准确答案,并在回应中附上该页链接;它不用于爬取网页,亦不用于收集训练内容。由于读取是由用户发起,文件写明这支爬虫一般会忽略 robots.txt 规则。
| 爬虫 | 用途 | 会否用作训练 | robots.txt | 官方 IP 清单 |
|---|---|---|---|---|
| PerplexityBot | 在搜索结果中呈现并链接网站 | 官方写明不会 | 官方建议放行 | perplexitybot.json |
| Perplexity-User | 用户提问时读取网页,答案附上链接 | 官方写明不会 | 一般会忽略 | perplexity-user.json |
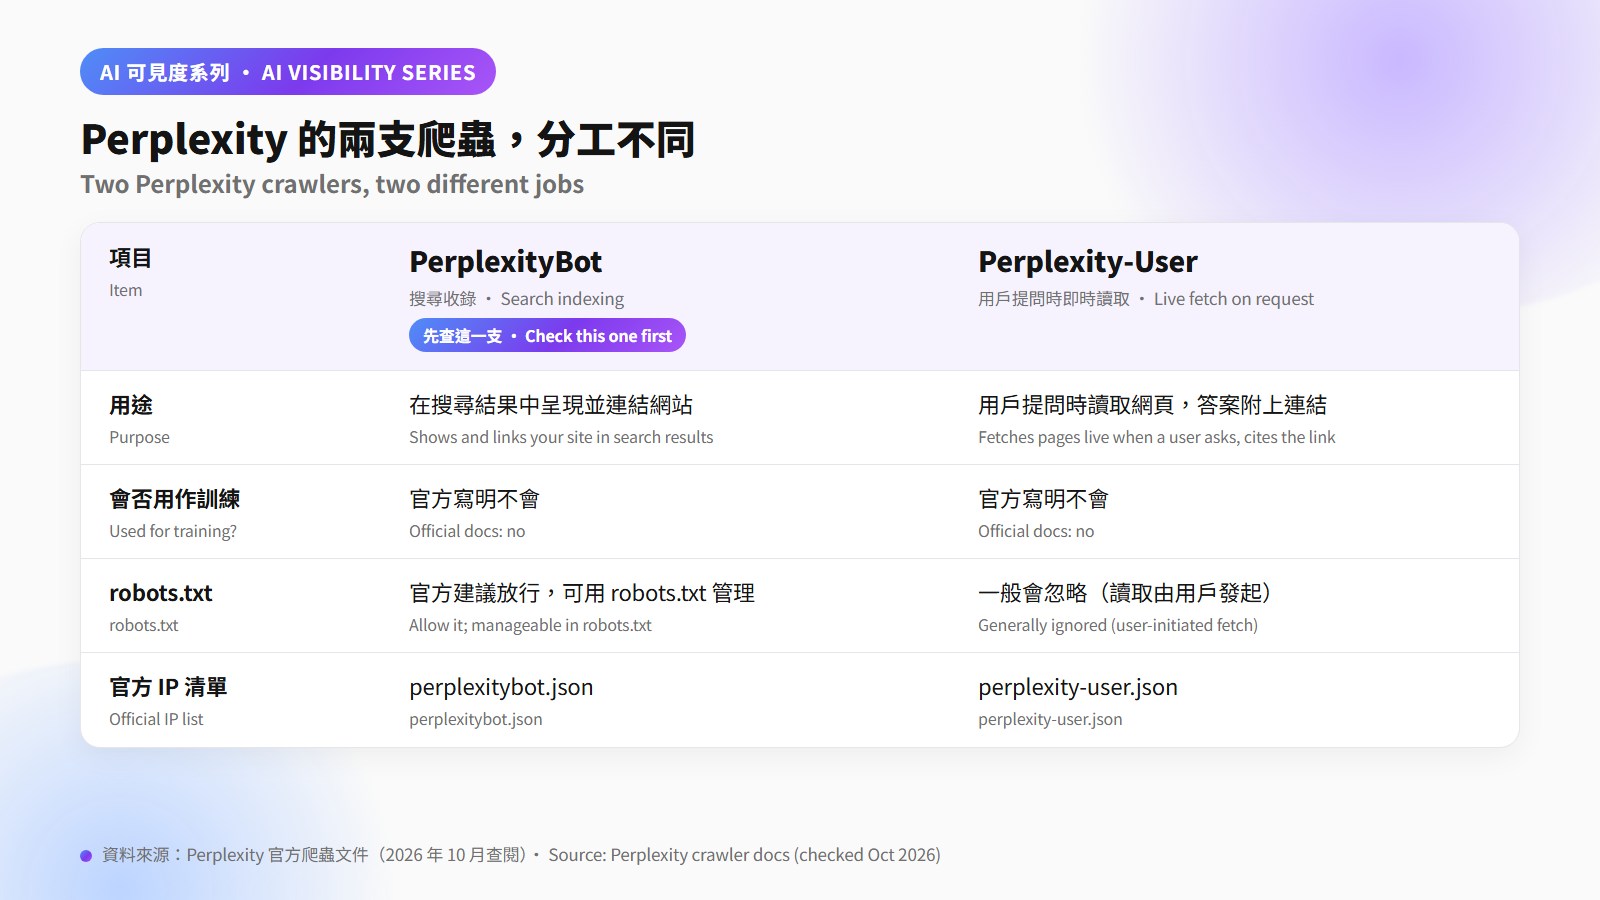
所以「Perplexity 搜索不到」要先看 PerplexityBot。OpenAI 的爬虫文件分法相近:OAI-SearchBot 管搜索,ChatGPT-User 处理用户操作。
第一步:robots.txt 有否封锁 PerplexityBot?
在浏览器打开「你的域名/robots.txt」,搜索 PerplexityBot。看到它底下有 Disallow: /,或者 User-agent: * 底下有 Disallow: / 而没有另外为 PerplexityBot 开放,即属封锁。另外要确认 robots.txt 打开后直接显示纯文字规则,而不是转去另一个网页或显示错误页;Perplexity 文件没有说明它怎样处理这类情况,最稳妥是让规则文件可以直接读取。放行的写法:
User-agent: PerplexityBot
Allow: /
Perplexity 官方文件写明,每个设置独立运作,系统最多需要 24 小时反映改动,改完次日再测试。其他 AI 爬虫的名单与写法见《AI 爬虫完整指南》。
第二步:防火墙有否挡下 Perplexity 的官方 IP?
robots.txt 放行了,请求仍可能在防火墙被挡,所以要按官方 IP 清单放行。Perplexity 官方文件提供两份清单:PerplexityBot 用 perplexitybot.json,Perplexity-User 用 perplexity-user.json,并建议规则同时比对 User-Agent 与 IP,每支爬虫对应自己的 IP 范围。User-Agent 只是一串自报的名称,官方的最佳做法是两者一并核对,以提高安全,同时确保真正的 Perplexity 爬虫进得来。
文件列出两个常见防火墙的设置:
- Cloudflare:在 Security rules 新增自订规则,条件写「User-Agent 含 PerplexityBot 而且来源 IP 在官方清单内」,动作选 Skip,并勾选要略过的安全功能(官方例子有 All remaining custom rules、All managed rules、All rate limiting rules),再把规则放在所有阻挡或质询规则之上,因为 Skip 只会略过排在它之后的规则。官方特别提醒,Bot Fight Mode 不能用自订规则略过,开了它仍可能拦截 Perplexity 的爬虫。
- AWS WAF:为两支爬虫各建一个 IP 集,规则同时比对 IP 集与 User-Agent,动作设为 Allow,优先次序排在阻挡规则之前。
同一份文件说明 IP 清单会定期更新,建议设置自动程序定期取得最新范围。网站由建站公司或托管商代管的话,把两个 JSON 网址交给他们处理即可。改好后,可以在服务器访问日志搜索 PerplexityBot,并核对来源 IP 是否在官方清单内。
第三步:在 Perplexity 问自家品牌,答案引用了哪些网页?
直接在 Perplexity 提问,看答案附上的链接有否你的网站。官方文件写明 PerplexityBot 用于在搜索结果中链接网站,Perplexity-User 可能在回应中附上所读网页的链接;答案附有链接时,可以逐一开启核对。
建议问三类问题:
- 品牌问题:「某某公司是做什么的?」
- 服务加地区:「荃湾有哪些做室内设计的公司?」
- 比较问题:「某某公司与同类服务有什么分别?」
每条记下答案有否提到你、链接是否指向你的官网、资料是否正确,并保存截图与日期,修改网站后用同一组问题重测比较。答案只引用第三方网页而没有你的官网,就回到第一、二步再查。
第四步:用 AEO Auditor 看还有什么读不到?
爬虫进得来之后,还要看网站内容读不读得懂。AEO Auditor 输入网址即可免费检测,工具页列明报告涵盖 AI 爬虫访问性、schema markup 与内容可回答性,可以一次检视结构与文案。内容方面的常见原因,例如内容不是可引用的陈述句、品牌资讯不一致,见《为什么 ChatGPT 搜索不到你的公司网站》,亦值得一并检查。
常见问题
PerplexityBot 会用我的内容训练模型吗?
Perplexity 官方文件写明,PerplexityBot 不用于为 AI 基础模型抓取内容;Perplexity-User 亦不用于收集训练内容。
robots.txt 能阻挡 Perplexity-User 吗?
官方文件写明,由于读取由用户发起,Perplexity-User 一般会忽略 robots.txt 规则。防火墙规则则可以按 User-Agent 与各自的官方 IP 清单分开设置。
改了 robots.txt,Perplexity 多久会更新?
Perplexity 官方文件写明,系统最多需要 24 小时反映 robots.txt 的改动。
用了 Cloudflare,为什么 Perplexity 仍被挡?
其中一个可能是 Bot Fight Mode。官方文件写明,Bot Fight Mode 不能用自订规则略过,开了它仍可能拦截 Perplexity 的爬虫;另外要确认放行规则排在阻挡规则之上,并已勾选要略过的安全功能。
资料来源
- Perplexity,Perplexity Crawlers:https://docs.perplexity.ai/docs/resources/perplexity-crawlers(2026-10-31 查阅)
- Perplexity,PerplexityBot IP 范围:https://www.perplexity.ai/perplexitybot.json(2026-10-31 查阅)
- Perplexity,Perplexity-User IP 范围:https://www.perplexity.ai/perplexity-user.json(2026-10-31 查阅)
- OpenAI,Overview of OpenAI Crawlers:https://developers.openai.com/api/docs/bots(2026-10-31 查阅)